Mein eigenes Sprachmodell erfindet Vornamen
GPT im Kleinformat, auf dem Laptop trainiert. Es erfindet Namen wie Arnelinde und Kundhilde und manchmal eben Hannne.
Ich erkläre ständig, wie Sprachmodelle funktionieren. Irgendwann wollte ich eins von Grund auf selbst bauen, statt nur darüber zu reden.
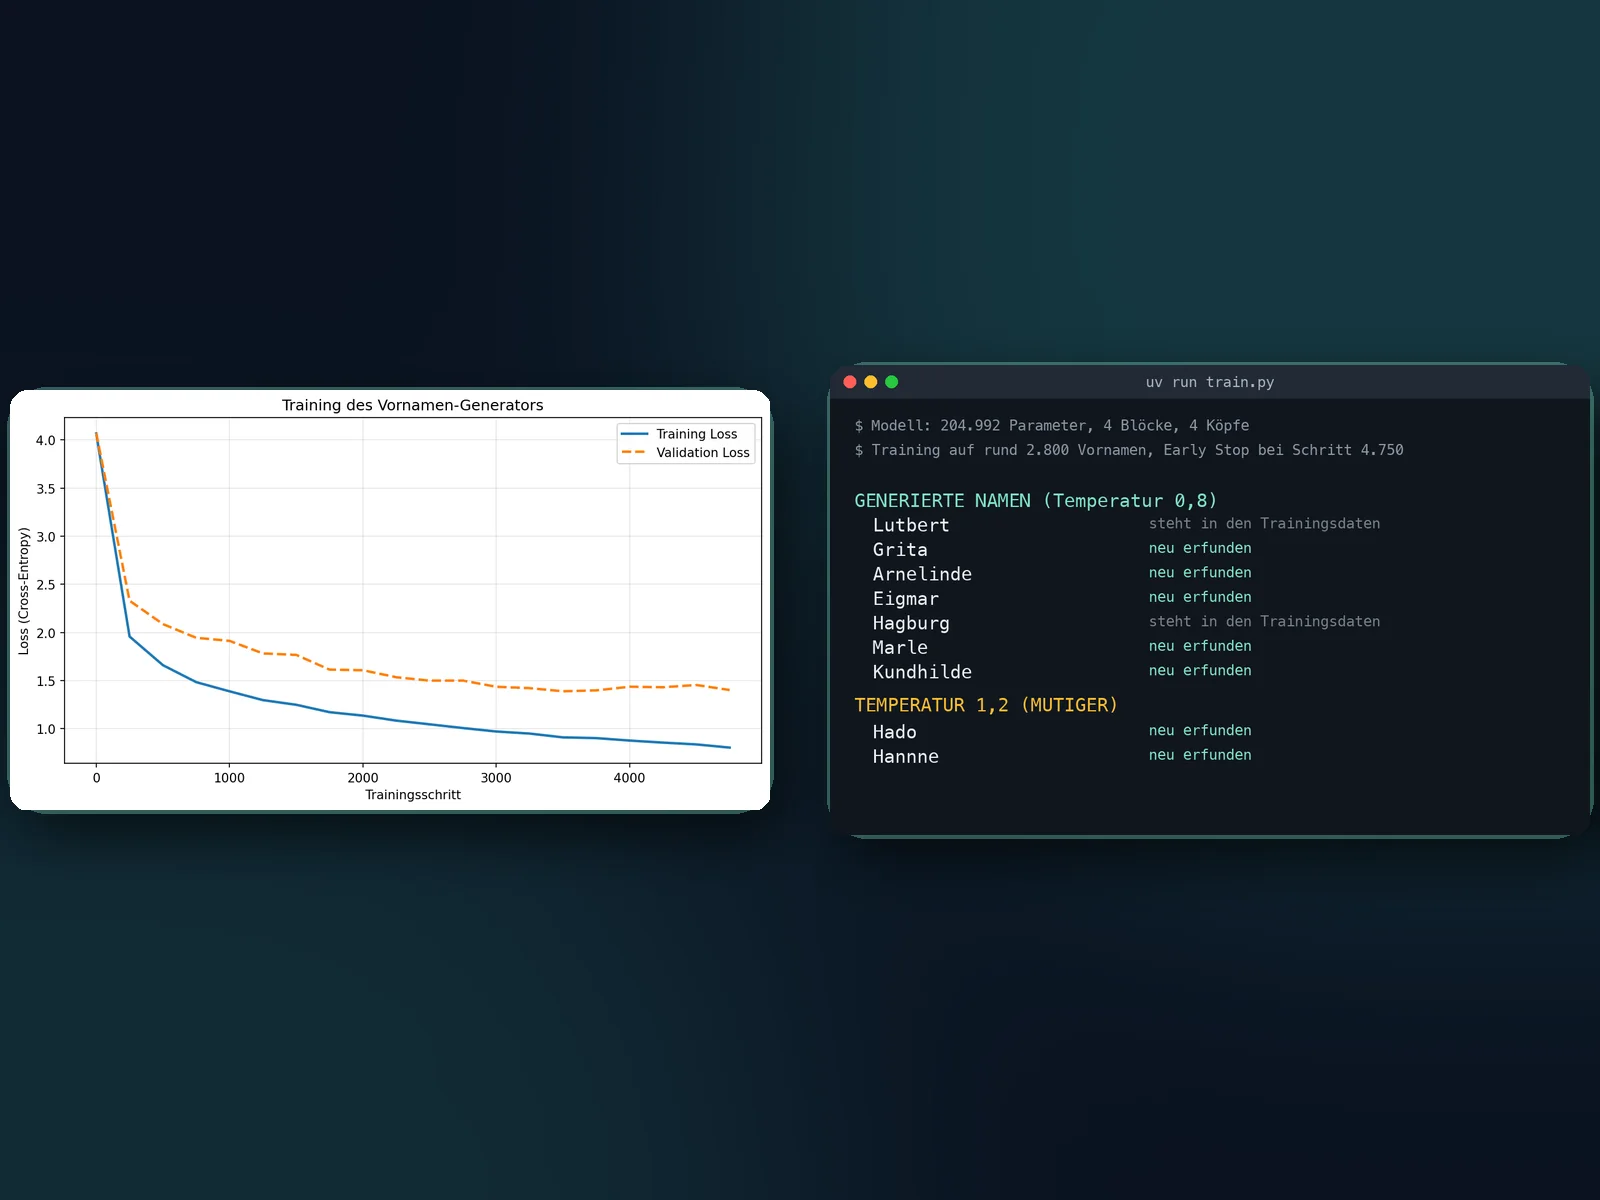
Herausgekommen ist ein Transformer nach dem Bauplan von GPT, nur rund 600-mal kleiner als GPT-2: 205.000 Parameter, vier Blöcke, vier Aufmerksamkeitsköpfe, ein Buchstabe pro Token. Trainiert habe ich ihn auf dem MacBook mit rund 2.800 deutschen Vornamen, in ein paar Minuten. Danach erfindet er Namen, die es nicht gibt, die aber deutsch klingen: Arnelinde, Eigmar, Kundhilde.
Ganz so kreativ ist er allerdings nicht. Je nach Lauf ist nur gut ein Drittel bis knapp die Hälfte der Namen wirklich neu, den Rest kennt er aus den Trainingsdaten. Und dreht man die Temperatur hoch, kommt auch mal Hannne heraus, mit drei n.
Im zweiten Schritt habe ich ein fertiges Modell mit drei Milliarden Parametern per LoRA nachtrainiert, damit es aus geschäftlichen E-Mails Absicht, Dringlichkeit und Aufgaben herauszieht. Die 80 Trainingsmails dafür waren ausgedacht, gerechnet hat wieder der Laptop.
Fazit
Wer einmal zugesehen hat, wie die Fehlerkurve fällt und das Modell vom Raten zum Buchstabieren kommt, versteht große Sprachmodelle anders. Das Prinzip ist dasselbe, nur der Maßstab nicht.
Ausblick
Aus dem Projekt ist eine ausführliche Erklärung mit Grafiken geworden, von der Tokenisierung bis zur Temperatur. Sie soll als Anschauungsmaterial in meine Workshops wandern.